YouTubeなどの動画の英語をリアルタイムで翻訳したい。
ブラウザの拡張機能だと物足りない、デスクトップ上で手軽に動かしたいという方に向けて、Pythonでローカル(デスクトップ)で動く翻訳ツールを作成しました。
音声認識に高速な Faster-Whisper、翻訳に無料枠で使える超高速な Gemini API を組み合わせ、文節ごとに綺麗に区切って表示・コピーできる実用的なツールです。
ここではジェミニを使いましたが、APIの部分を書き換えればローカルでも可能だと思います。
環境はひとそれぞれだと思いますのでてきとーに編集してください。
ここでやるのはライブラリのインストールとAPIキーの入力くらいです。
どんなことができる?
デスクトップのシステム音声を日本語に翻訳
マイクでの入力も可能(案外英語の学習に使える)
テキストのコピー
※APIを挟むのでワンクッションあきます。大雑把な内容を知りたい時などに便利です。
https://www.youtube.com/watch?v=9HFtcxRpP8c
向いている人:
・拡張機能をさまよったけど結局有料かよっ!ってなった人
・ざっくりでいい人
・英語の勉強をしたい人(マイクだと自分の英語をチェックできます)
向いていない人:
・映画など超リアルタイムにこだわる人(どうしても遅延は出ます)
・高度な機能が欲しい人
・英語が話せる人
- 1. どんなことができる?
- 1.1.1.1. 向いている人:
- 1.1.1.2. 向いていない人:
- 2. 1. 動作環境と必要なもの
- 2.1. 推奨環境
- 2.2. 必要なライブラリ(pipインストール)
- 2.2.1. ライブラリ
- 2.3. 事前準備
- 3. 2. ツールの大まかな仕組みと流れ
- 4. 3. 導入・実行手順
- 5. ⚠️ 重要:AIモデルの指定に関する注意点
- 6. 4. チューニング・設定変更のポイント(エラー対策)
- 6.1. ① APIを変更・最新化したい場合
- 6.2. ② 音声のリクエストが多すぎてエラー(429 Too Many Requests)になる場合
- 7. 5. 完成Pythonコード
- 7.1.1. コード
- 8. 💡 ポイント
- 9. 🛠️ トラブルシューティング:よくあるエラーと対処法
- 9.1. Q1. 「429 Too Many Requests」というエラーが出る場合
- 9.2. Q2. 「音声が取得できない」「デバイスが見つからない」と言われる場合
- 9.3. Q3.翻訳の前の?の意味が分からない
【Python】PC音声&マイク対応!Gemini API & Whisper でリアルタイム英語翻訳デスクトップツールを作る
1. 動作環境と必要なもの
推奨環境
- OS: Windows 11 / 10
- Pythonバージョン: Python 3.10 〜 3.12
- ハードウェア: NVIDIA製GPU(CUDA対応、例: RTX 3070等)があると音声認識が速くなります(CPUのみでも動作可能ですが処理に時間がかかります)
必要なライブラリ(pipインストール)
以下のコマンドを実行してあらかじめインストールしておきます。
ライブラリ
pip install faster-whisper google-genai PySide6 sounddevice soundcard numpy
事前準備
- Gemini APIキーの取得: Google AI Studio にて無料でAPIキーを発行しておきます。
2. ツールの大まかな仕組みと流れ
- 音声の取得: 「PC音声(相手の会話や動画の音)」または「マイク(自分の声や通話)」をリアルタイムでキャプチャします。
- 無音区間の判定(VAD): 一定の無音時間や文章の区切りを検知し、短すぎず長すぎない「ちょうど良い文節」の単位で音声を切り出します。
- 音声認識(STT): 切り出した音声をローカルの Faster-Whisper が超高速で英語テキストに変換します。
- AI翻訳: 変換された英語を Gemini API に送り、会話として自然な日本語に翻訳してデスクトップアプリ上の画面にリアルタイムで表示します。
3. 導入・実行手順
- APIキーの設定: 後述の完成コード内にある
API_KEY = "ここにAPIキー"の部分をご自身のGemini APIキーに書き換えます。 - ファイルの保存: コードを
translator.pyなどの名前で保存します。 - 実行: コマンドプロンプトやターミナルで以下のコマンドを実行します。
Bashpython translator.py - 使い方の流れ:
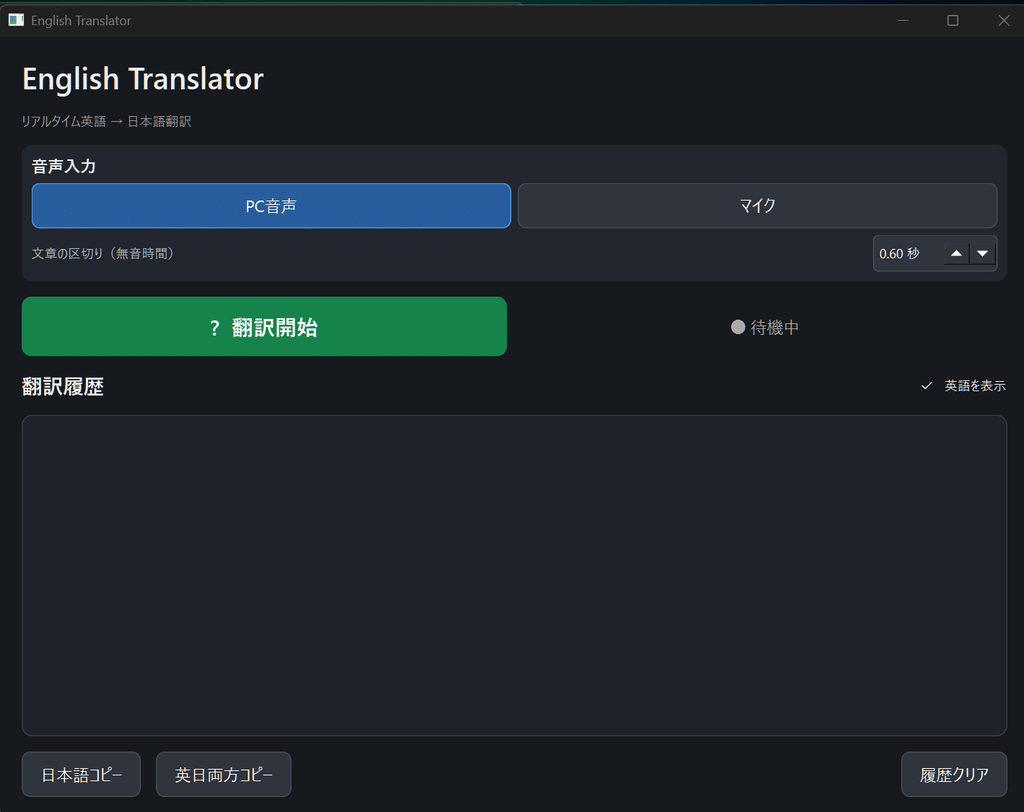
- アプリが起動したら「PC音声」または「マイク」を選択します。
- 「翻訳開始」ボタン を押すと、音声のキャプチャと翻訳がスタートします。
- ウィンドウ内にリアルタイムで日本語訳(およびオプションで英語)が積み上がっていきます。
- 必要に応じて「日本語コピー」や「英日両方コピー」ボタンでクリップボードへワンタッチ保存できます。
⚠️ 重要:AIモデルの指定に関する注意点
コード内の GEMINI_MODEL に "gemini-2.0-flash-exp""gemini-1.5-flash" のような存在しないバージョンや架空の型番を指定すると、AIが勝手に補正しようとしたり、APIエラーが発生して動きません。
現在公式で提供されている、高速かつ無料枠で安定して動作するモデル名は以下の通りです。必ずこれらを指定してください。と息を吐くようにAIは指示しますが無視してください。
使うのは gemini-3.5-flash-lite です。(時期によって変わるかも)20261109 時点
4. チューニング・設定変更のポイント(エラー対策)
運用していて「設定を変更したい」「エラー(APIの回数制限など)が出る」場合の調整箇所をまとめました。
① APIを変更・最新化したい場合
コード内の以下の変数を書き換えます。
ここを他社とかローカルに変えるといけると思います。
やってないんかーい!(うちのローカルしょぼくってすんません)
Python
# モデルを変更する場合
GEMINI_MODEL = "gemini-3.5-flash-lite"
② 音声のリクエストが多すぎてエラー(429 Too Many Requests)になる場合
無料枠の制限に引っかかったり、早口で細切れになりすぎてAPIへのリクエスト頻度が高すぎる場合は、以下の数値を大きくして「まとまった文章になってから送信する」ように調整します。
もっと早くリアルタイムに翻訳しようと数値を上げると無料枠だとリクエストが多すぎや!とエラーになります。
お金持ちの人は調整してみてください。
SILENCE_SEC = 0.6- 文章の区切りとみなす無音時間(秒)。長めの文脈で区切りたい場合は
0.8や1.0に増やします。
- 文章の区切りとみなす無音時間(秒)。長めの文脈で区切りたい場合は
MIN_SEC = 1.2- 翻訳へ送る最小の音声の長さ(秒)。短すぎる誤認を防ぎたい場合は
1.5や2.0に増やします。
- 翻訳へ送る最小の音声の長さ(秒)。短すぎる誤認を防ぎたい場合は
MAX_SEC = 5.0- 一度に処理する最大秒数。
5. 完成Pythonコード
蕁麻疹が出ても大丈夫!
APIの部分を変えるくらいです。
その他こだわりがある方や高性能なAPIを使える人は変更してください。
マイクが認識しない場合、ウインドウズの右下のスピーカーマークからサウンドの設定でマイクが選ばれているかチェックしてください。
コード
import os
import site
import sys
import threading
import queue
import html
import time
import subprocess

# CUDA / cuDNN の DLL パス自動認識(RTX 3070 用)
for sp in site.getsitepackages():
    for name in ["cublas", "cudnn"]:
        bin_path = os.path.join(sp, "nvidia", name, "bin")
        if os.path.exists(bin_path):
            os.add_dll_directory(bin_path)
            os.environ["PATH"] = bin_path + os.pathsep + os.environ["PATH"]

import numpy as np
import sounddevice as sd  # USBマイク用

from faster_whisper import WhisperModel
from google import genai
from google.genai import types

from PySide6.QtCore import QObject, Signal, Qt
from PySide6.QtGui import QFont
from PySide6.QtWidgets import (
    QApplication, QWidget, QVBoxLayout, QHBoxLayout,
    QPushButton, QTextEdit, QLabel, QButtonGroup,
    QCheckBox, QDoubleSpinBox, QFrame
)


# ==========================================
# 設定
# ==========================================

# あなたの Gemini APIキーを入れてください
API_KEY = "ここにAPIキー"

# Google公式の最新・超高速モデル
GEMINI_MODEL = "gemini-3.5-flash-lite"

# 高速・高精度な英語モデル(RTX 3070 で爆速動作)
WHISPER_MODEL = "small.en"
DEVICE = "cuda"
COMPUTE_TYPE = "float16"

SR = 16000
BLOCK_SEC = 0.1

# 429制限を回避しつつリアルタイム性を保つ設定
SILENCE_SEC = 0.6
MIN_SEC = 1.2
MAX_SEC = 5.0

SILENCE_THRESHOLD = 0.005
AUDIO_QUEUE_SIZE = 12


# ==========================================
# 共有状態
# ==========================================

audio_q = queue.Queue(maxsize=AUDIO_QUEUE_SIZE)


class State:
    def __init__(self):
        self.lock = threading.Lock()
        self.session = 0
        self.active = False

    def start(self):
        with self.lock:
            self.session += 1
            self.active = True
            return self.session

    def stop(self):
        with self.lock:
            self.active = False

    def is_active(self, session):
        with self.lock:
            return self.active and self.session == session


state = State()


# ==========================================
# GUIとの通信
# ==========================================

class Signals(QObject):
    status = Signal(int, str)
    result = Signal(int, str, str, str)
    error = Signal(int, str)


signals = Signals()


# ==========================================
# 音声取得(PC音声: soundcard / マイク: sounddevice)
# ==========================================

def capture(session, mode, stop_event, silence_sec):

    try:
        buf = []
        silent = 0
        voiced = False

        silence_blocks = max(1, int(silence_sec / BLOCK_SEC))
        min_blocks = int(MIN_SEC / BLOCK_SEC)
        max_blocks = int(MAX_SEC / BLOCK_SEC)
        block_frames = int(SR * BLOCK_SEC)

        signals.status.emit(session, "録音中")

        # ------------------------------------------
        # 【マイク】sounddevice を使用(USBマイク対応)
        # ------------------------------------------
        if mode == "マイク":
            with sd.InputStream(samplerate=SR, channels=1, dtype='float32') as stream:
                while not stop_event.is_set():
                    data, _ = stream.read(block_frames)
                    if stop_event.is_set():
                        break

                    data = data.flatten()
                    buf.append(data)

                    rms = np.sqrt(np.mean(data ** 2))
                    if rms < SILENCE_THRESHOLD:
                        silent += 1
                    else:
                        silent = 0
                        voiced = True

                    finished = (
                        silent >= silence_blocks
                        and len(buf) >= min_blocks
                    ) or len(buf) >= max_blocks

                    if finished:
                        if voiced:
                            audio = np.concatenate(buf).astype(np.float32)
                            if audio_q.full():
                                try:
                                    audio_q.get_nowait()
                                except queue.Empty:
                                    pass
                            if state.is_active(session):
                                audio_q.put_nowait((session, mode, audio))

                        buf = []
                        silent = 0
                        voiced = False

        # ------------------------------------------
        # 【PC音声】soundcard を使用(ここで安全に読み込む)
        # ------------------------------------------
        else:
            import soundcard as sc
            speaker = sc.default_speaker()
            device = sc.get_microphone(id=str(speaker.name), include_loopback=True)

            with device.recorder(samplerate=SR, channels=1) as recorder:
                while not stop_event.is_set():
                    data = recorder.record(numframes=block_frames)[:, 0]
                    if stop_event.is_set():
                        break

                    buf.append(data)

                    rms = np.sqrt(np.mean(data ** 2))
                    if rms < SILENCE_THRESHOLD:
                        silent += 1
                    else:
                        silent = 0
                        voiced = True

                    finished = (
                        silent >= silence_blocks
                        and len(buf) >= min_blocks
                    ) or len(buf) >= max_blocks

                    if finished:
                        if voiced:
                            audio = np.concatenate(buf).astype(np.float32)
                            if audio_q.full():
                                try:
                                    audio_q.get_nowait()
                                except queue.Empty:
                                    pass
                            if state.is_active(session):
                                audio_q.put_nowait((session, mode, audio))

                        buf = []
                        silent = 0
                        voiced = False

    except Exception as e:
        import traceback
        err_msg = str(e) if str(e) else traceback.format_exc().strip().splitlines()[-1]
        if state.is_active(session):
            signals.error.emit(session, f"音声取得エラー:\n{err_msg}")


# ==========================================
# 音声認識・翻訳
# ==========================================

def worker():

    model = None
    client = None

    previous = {
        "PC音声": "",
        "マイク": ""
    }

    while True:

        try:
            session, mode, audio = audio_q.get(timeout=0.5)
        except queue.Empty:
            continue

        if not state.is_active(session):
            continue

        try:
            # Whisper 初期化
            if model is None:
                signals.status.emit(session, "音声認識モデルを準備中...")
                model = WhisperModel(
                    WHISPER_MODEL,
                    device=DEVICE,
                    compute_type=COMPUTE_TYPE
                )

            # Gemini クライアント初期化
            if client is None:
                client = genai.Client(api_key=API_KEY)

            signals.status.emit(session, "英語を認識中...")

            segments, _ = model.transcribe(
                audio,
                language="en",
                beam_size=1,
                vad_filter=True,
                condition_on_previous_text=False
            )

            english = " ".join(s.text.strip() for s in segments).strip()

            if not english:
                signals.status.emit(session, "録音中")
                continue

            if not state.is_active(session):
                continue

            signals.status.emit(session, "日本語に翻訳中...")

            prompt = f"""あなたは英日翻訳の専門家です。
以下の英語を自然で正確な日本語に翻訳してください。
会話として自然な日本語にし、翻訳結果だけを出力してください。

直前の英文: {previous[mode]}
今回の翻訳対象: {english}
"""

            response = None
            for retry in range(3):
                try:
                    response = client.models.generate_content(
                        model=GEMINI_MODEL,
                        contents=prompt,
                        config=types.GenerateContentConfig(
                            thinking_config=types.ThinkingConfig(thinking_level="minimal")
                        )
                    )
                    break
                except Exception as api_err:
                    if "429" in str(api_err) and retry < 2:
                        signals.status.emit(session, "混雑中...再試行します")
                        time.sleep(2)
                        continue
                    raise api_err

            japanese = response.text.strip() if response and response.text else "[翻訳結果なし]"

            if not state.is_active(session):
                continue

            previous[mode] = english

            signals.result.emit(session, mode, english, japanese)
            signals.status.emit(session, "録音中")

        except Exception as e:
            if state.is_active(session):
                signals.error.emit(session, f"処理エラー:\n{e}")


# ==========================================
# メイン画面 (GUI)
# ==========================================

class Win(QWidget):

    def __init__(self):
        super().__init__()

        self.setWindowTitle("English Translator")
        self.resize(950, 720)
        self.setMinimumSize(650, 500)

        self.history = []
        self.session = 0
        self.stop_event = None
        self.capture_thread = None

        self.setup_ui()

        signals.status.connect(self.set_status)
        signals.result.connect(self.add_result)
        signals.error.connect(self.show_error)

        threading.Thread(target=worker, daemon=True).start()

    def setup_ui(self):
        self.setStyleSheet("""
            QWidget { background: #17191e; color: #eeeeee; font-family: "Yu Gothic UI"; }
            QPushButton { background: #30343c; color: white; border: 1px solid #484d57; border-radius: 8px; padding: 10px 16px; font-size: 11pt; }
            QPushButton:hover { background: #414752; }
            QPushButton:checked { background: #285e9c; border: 1px solid #5599e8; }
            QPushButton:disabled { color: #777777; }
            QTextEdit { background: #20232a; color: white; border: 1px solid #3a3e48; border-radius: 10px; padding: 12px; }
            QLabel { color: #eeeeee; }
            QDoubleSpinBox { background: #30343c; color: white; border: 1px solid #484d57; border-radius: 5px; padding: 5px; }
            QCheckBox { spacing: 8px; }
        """)

        main = QVBoxLayout(self)
        main.setSpacing(14)
        main.setContentsMargins(20, 18, 20, 18)

        title = QLabel("English Translator")
        title.setFont(QFont("Yu Gothic UI", 21, QFont.Bold))
        main.addWidget(title)

        subtitle = QLabel("リアルタイム英語 → 日本語翻訳")
        subtitle.setStyleSheet("color:#999999;")
        main.addWidget(subtitle)

        # 音声入力設定
        setting = QFrame()
        setting.setStyleSheet("QFrame { background: #22262e; border-radius: 10px; }")
        setting_layout = QVBoxLayout(setting)

        setting_title = QLabel("音声入力")
        setting_title.setStyleSheet("font-size:11pt; font-weight:bold;")
        setting_layout.addWidget(setting_title)

        input_row = QHBoxLayout()
        self.btn_pc = QPushButton("PC音声")
        self.btn_mic = QPushButton("マイク")
        self.btn_pc.setCheckable(True)
        self.btn_mic.setCheckable(True)
        self.btn_pc.setChecked(True)

        self.input_group = QButtonGroup(self)
        self.input_group.setExclusive(True)
        self.input_group.addButton(self.btn_pc)
        self.input_group.addButton(self.btn_mic)

        input_row.addWidget(self.btn_pc)
        input_row.addWidget(self.btn_mic)
        setting_layout.addLayout(input_row)

        silence_row = QHBoxLayout()
        silence_label = QLabel("文章の区切り(無音時間)")
        silence_label.setStyleSheet("color:#bbbbbb;")
        self.silence_spin = QDoubleSpinBox()
        self.silence_spin.setRange(0.3, 2.0)
        self.silence_spin.setSingleStep(0.1)
        self.silence_spin.setValue(SILENCE_SEC)
        self.silence_spin.setSuffix(" 秒")
        silence_row.addWidget(silence_label)
        silence_row.addStretch()
        silence_row.addWidget(self.silence_spin)
        setting_layout.addLayout(silence_row)

        main.addWidget(setting)

        # コントロール
        control = QHBoxLayout()
        self.btn_run = QPushButton("?  翻訳開始")
        self.btn_run.setMinimumHeight(55)
        self.btn_run.setStyleSheet("""
            QPushButton { background: #16834b; border: none; border-radius: 9px; font-size: 15pt; font-weight: bold; }
            QPushButton:hover { background: #1c9a59; }
        """)
        control.addWidget(self.btn_run)

        self.status_label = QLabel("● 待機中")
        self.status_label.setAlignment(Qt.AlignCenter)
        self.status_label.setMinimumWidth(180)
        self.status_label.setStyleSheet("color:#aaaaaa; font-size:11pt;")
        control.addWidget(self.status_label)
        main.addLayout(control)

        # 履歴表示
        history_row = QHBoxLayout()
        history_title = QLabel("翻訳履歴")
        history_title.setFont(QFont("Yu Gothic UI", 14, QFont.Bold))
        self.en_check = QCheckBox("英語を表示")
        self.en_check.setChecked(True)
        history_row.addWidget(history_title)
        history_row.addStretch()
        history_row.addWidget(self.en_check)
        main.addLayout(history_row)

        self.view = QTextEdit()
        self.view.setReadOnly(True)
        self.view.setFont(QFont("Yu Gothic UI", 12))
        main.addWidget(self.view, 1)

        bottom = QHBoxLayout()
        self.btn_copy_ja = QPushButton("日本語コピー")
        self.btn_copy_all = QPushButton("英日両方コピー")
        self.btn_clear = QPushButton("履歴クリア")
        bottom.addWidget(self.btn_copy_ja)
        bottom.addWidget(self.btn_copy_all)
        bottom.addStretch()
        bottom.addWidget(self.btn_clear)
        main.addLayout(bottom)

        self.btn_run.clicked.connect(self.toggle_run)
        self.en_check.toggled.connect(self.render)
        self.btn_copy_ja.clicked.connect(lambda: self.copy_text(False))
        self.btn_copy_all.clicked.connect(lambda: self.copy_text(True))
        self.btn_clear.clicked.connect(self.clear)

    def toggle_run(self):
        if state.is_active(self.session):
            self.stop_capture()
        else:
            self.start_capture()

    def start_capture(self):
        mode = "PC音声" if self.btn_pc.isChecked() else "マイク"
        self.session = state.start()
        self.stop_event = threading.Event()

        self.capture_thread = threading.Thread(
            target=capture,
            args=(self.session, mode, self.stop_event, self.silence_spin.value()),
            daemon=True
        )
        self.capture_thread.start()

        self.btn_run.setText("■  翻訳停止")
        self.btn_run.setStyleSheet("""
            QPushButton { background: #a63b3b; border: none; border-radius: 9px; font-size: 15pt; font-weight: bold; }
            QPushButton:hover { background: #c54b4b; }
        """)
        self.btn_pc.setEnabled(False)
        self.btn_mic.setEnabled(False)
        self.silence_spin.setEnabled(False)
        self.status_label.setText("● 起動中")

    def stop_capture(self):
        state.stop()
        if self.stop_event:
            self.stop_event.set()

        while True:
            try:
                audio_q.get_nowait()
            except queue.Empty:
                break

        self.btn_run.setText("?  翻訳開始")
        self.btn_run.setStyleSheet("""
            QPushButton { background: #16834b; border: none; border-radius: 9px; font-size: 15pt; font-weight: bold; }
        """)
        self.btn_pc.setEnabled(True)
        self.btn_mic.setEnabled(True)
        self.silence_spin.setEnabled(True)
        self.status_label.setText("● 待機中")

    def set_status(self, session, message):
        if session != self.session or not state.is_active(session):
            return
        self.status_label.setText("● " + message)

    def add_result(self, session, mode, en, ja):
        if session != self.session or not state.is_active(session):
            return
        self.history.append({"mode": mode, "en": en, "ja": ja})
        self.render()

    def show_error(self, session, message):
        if session != self.session or not state.is_active(session):
            return
        self.status_label.setText("● エラー")
        self.status_label.setStyleSheet("color:#ff7777; font-size:11pt;")
        self.history.append({"mode": "エラー", "en": "", "ja": message})
        self.render()

    def render(self, *_):
        content = ""
        for item in self.history:
            mode = html.escape(item["mode"])
            en = html.escape(item["en"])
            ja = html.escape(item["ja"])

            content += f"""
            <div style="background:#292d36; border-radius:9px; padding:15px; margin-bottom:12px;">
                <div style="color:#999999; font-size:10pt; margin-bottom:8px;">[{mode}]</div>
                <div style="color:#ffffff; font-size:17pt; font-weight:600; line-height:1.5; margin-bottom:8px;">{ja}</div>
            """
            if self.en_check.isChecked() and en:
                content += f'<div style="color:#aaaaaa; font-size:11pt; line-height:1.5;">{en}</div>'
            content += "</div>"

        self.view.setHtml(content)
        scrollbar = self.view.verticalScrollBar()
        scrollbar.setValue(scrollbar.maximum())

    # 確実にクリップボードにコピーする処理(Windows標準のclipコマンド使用)
    def copy_text(self, both):
        if both:
            text = "\n\n".join(f'{x["en"]}\n{x["ja"]}' for x in self.history if x["en"] or x["ja"])
        else:
            text = "\n\n".join(x["ja"] for x in self.history if x["ja"])

        if not text:
            return

        try:
            subprocess.run(
                ["clip"],
                input=text.strip().encode("utf-16"),
                creationflags=subprocess.CREATE_NO_WINDOW,
                check=True
            )
            self.status_label.setText("● コピーしました")
        except Exception as e:
            print(f"Clipboard error: {e}")

    def clear(self):
        self.history.clear()
        self.render()

    def closeEvent(self, event):
        state.stop()
        if self.stop_event:
            self.stop_event.set()
        event.accept()


# ==========================================
# 起動
# ==========================================

if __name__ == "__main__":
    app = QApplication(sys.argv)
    window = Win()
    window.show()
    sys.exit(app.exec())
💡 ポイント
- ブラウザ拡張機能いらずの独立アプリ ブラウザのタブに縛られず、PC上で独立したウィンドウとして常時手軽に起動できます。
- PC音声とマイクの切り替えに対応 YouTube、動画配信、海外ツールなどの「PC音声(システム音声)」だけでなく、ヘッドセットや「マイク」からの音声もワンボタンで切り替えてリアルタイム翻訳できます。
- ローカルAI(Whisper)+クラウドAI(Gemini)のハイブリッド構成 音声の文字起こしは手元のPC(GPU)で超高速かつ無料で処理し、翻訳の「自然さ・文脈理解」だけを賢いGemini APIに任せることで、遅延の少なさと高い翻訳精度を両立しています。
🛠️ トラブルシューティング:よくあるエラーと対処法
Q1. 「429 Too Many Requests」というエラーが出る場合
- 原因: 無料版のGemini APIには1分あたりのリクエスト数(回数制限)があります。あまりにも早口で細切れに音声が送られると制限に引っかかります。
- 対策: コード内の以下の数値を少し大きくして、文章がまとまってから送信されるように調整してください。
PythonSILENCE_SEC = 1.0 # 無音と判定する時間を長めにする(例: 0.6 → 1.0) MIN_SEC = 1.5 # 翻訳に送る最小の秒数を増やす
Q2. 「音声が取得できない」「デバイスが見つからない」と言われる場合
- 原因: Windowsのサウンド設定や、使用しているマイク・スピーカーのドライバが正しく認識されていない可能性があります。
- 対策: アプリを起動する前に、利用したいマイクやスピーカーがWindows側で正しく既定のデバイスに設定されているか確認してください。
Q3.翻訳の前の?の意味が分からない
・原因なんかの文字化け?日本語が見れたらいいので直してません。気になる方は修正してください。
初心者さんにもとっても分かりやすいと好評です
今だけのプレゼントも配布中!